


Apple 在 macOS 27 之後放進了 AFM (Apple Foundation Model),宣稱有 local model + Apple Private Cloud,目標是執行任務時
可以選擇 local model 運算或是 PCC。但想把小模型放進日常工作,從系統執行,我會關注兩個事情:request 之後,多久收到第一段文字?思考到回答要多久?
這次我用 M1 Air 16GB,比較 Apple fm system、Microsoft Phi-4 Mini、Mistral Ministral 3 3B、Google Gemma 4 E2B/E4B。
摘要都能跑,但這張表不是模型能力排行榜。比起急著選冠軍,先看你到底送了什麼 prompt。
簡單測試方式
macOS 27.2、m1 air 16G。其中 MLX 使用 4-bit 權重;Apple system 模型透過 fm serve 的本機 HTTP 介面呼叫。
同一段合成提示如下,沒有使用真實會議資料:
請將以下會議內容整理成一句繁體中文摘要,30至50字,不要標題:團隊決定先完成登入頁,週三前由小林交付;付款功能延到下週,需等測試通過。
五個主要實作,加兩個 Ministral 控制設定,每組先暖身一次、正式跑五次,共 35 次正式完成。35 次是同一任務的重複測量,不是 35 種任務。 正式批次均以正常 stop 結束、沒有截斷;這不代表摘要已通過品質驗收。
TTFT:計時開始到收到第一個非空文字 chunk/delta。不是原始第一個 token,也不是瀏覽器畫出第一個字的時間。
E2E:計時開始到文字串流結束。
MLX 計時從套用模板之後、呼叫生成之前開始;fm 從 HTTP 請求前開始,包含該路徑的 HTTP/session 開銷。模型載入與服務啟動不包含在以下數字。
輸出上限為 512 tokens;請求 temperature=0。fm 的實際採樣與隱藏模板未獨立驗證。
五次正式測量的中位數
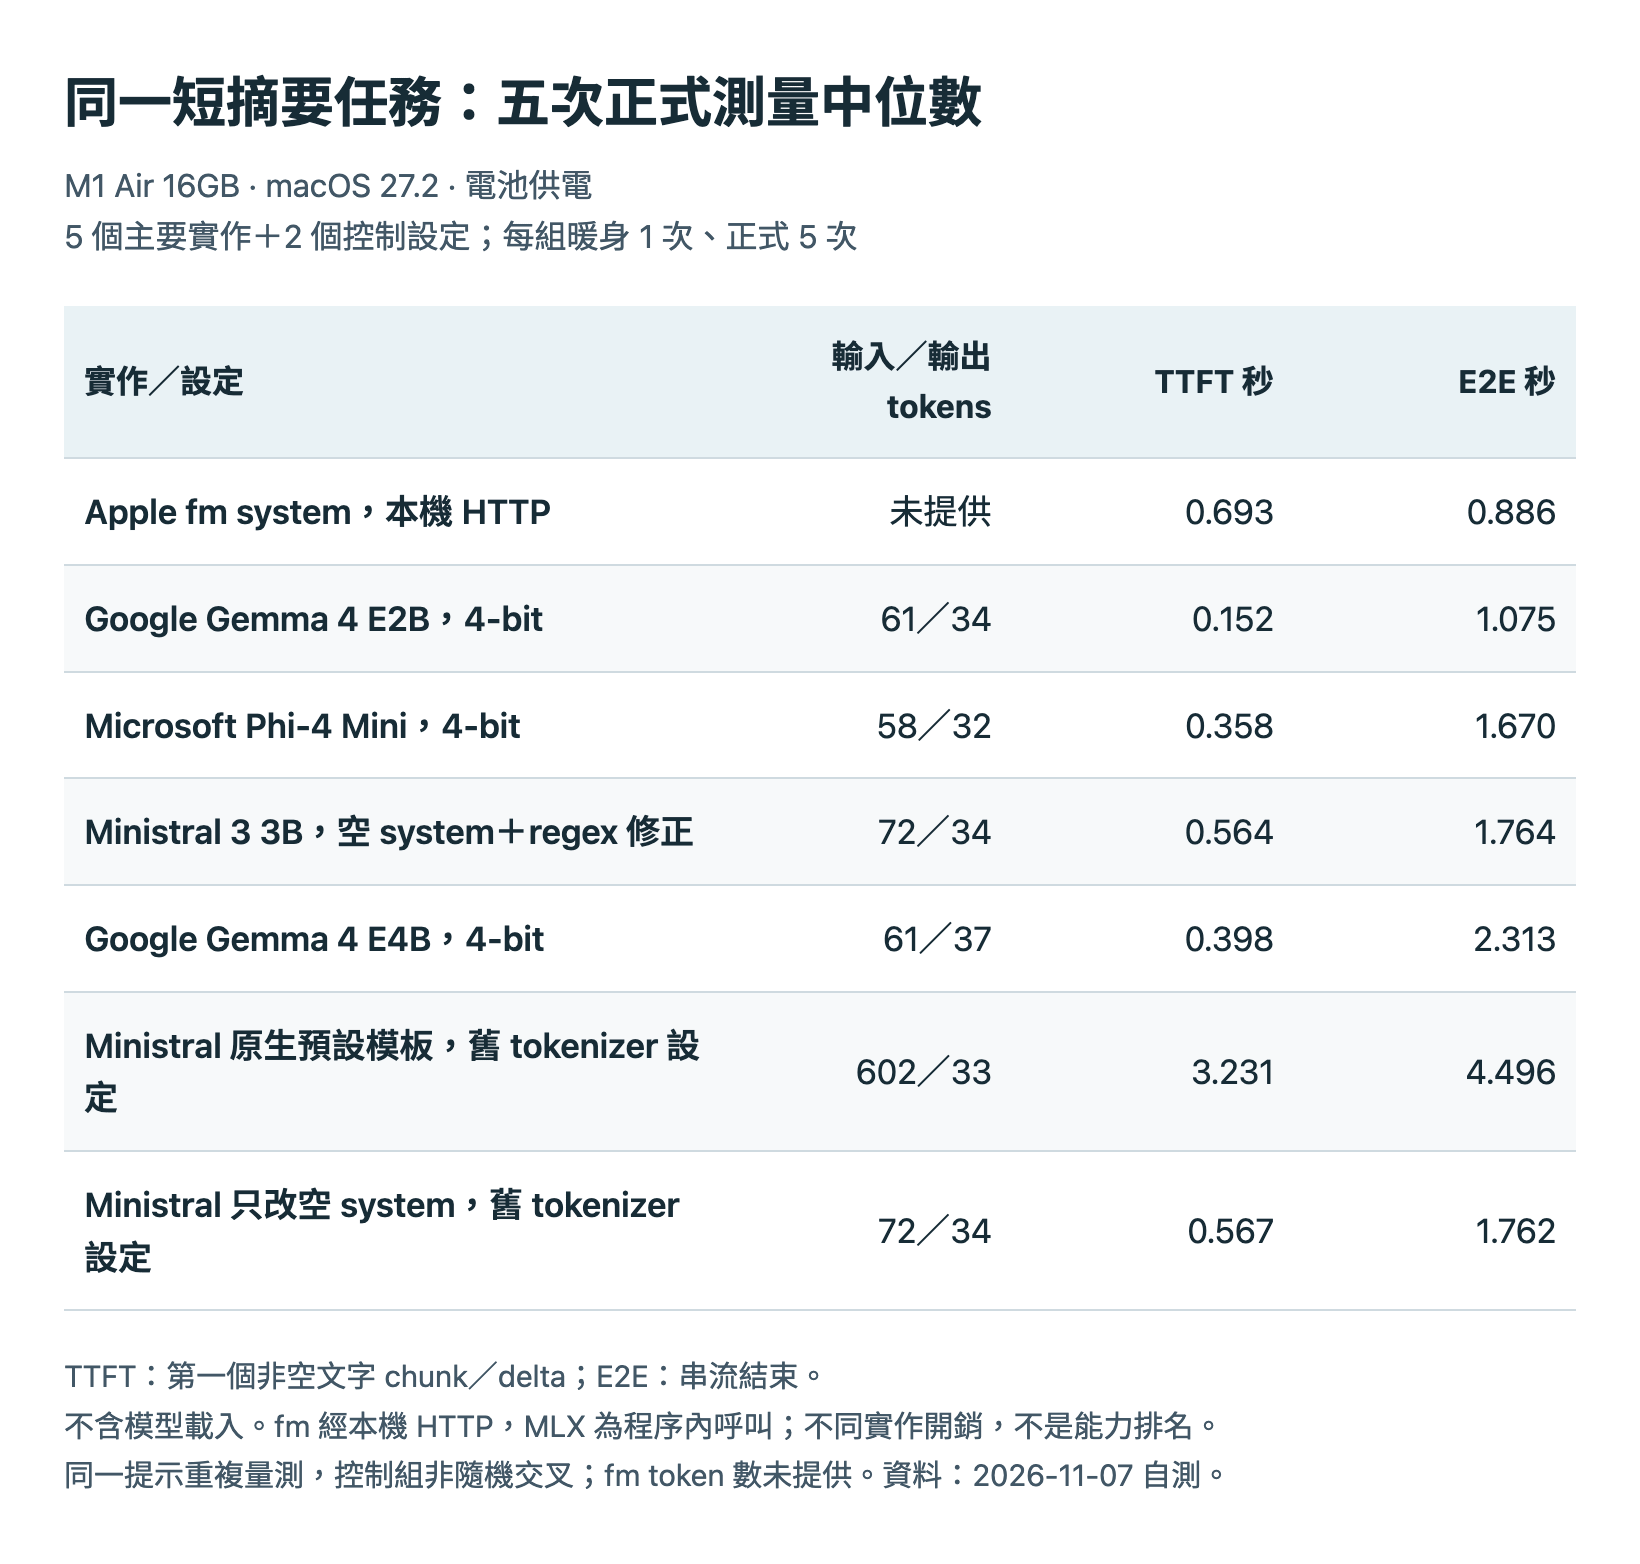
fm 在這個任務的 E2E 最短,Gemma E2B 的 TTFT 最短;不能因此推論誰的模型內部更快,或誰比較適合所有 agent 工作。 兩種呼叫路徑的開銷不同,tokenizer 與輸出長度也不相同。fm 的 SSE 未提供 usage,不能補造 token 數或 tokens/s。
原來同一句話,並不等於相同輸入
Ministral 原生預設模板會插入很長的 system message,這次記錄到 602 個輸入 tokens。顯式空 system 後變成 72 個,TTFT 中位數也從 3.231 秒變成 0.567 秒。
這個觀察提醒我:做 agent 時,system prompt、工具描述與模板預設值都是負擔的一部分。不能把第一輪全部延遲差距都歸因於模型本身。
但我也不能把差距全部歸因於那段 system message:控制組在不同時間順序執行,沒有隨機交叉,page cache 狀態未知,而且 system 內容本身也改了。
舊 tokenizer 設定另外出現 regex 警告。我保留原始結果,另以 fix_mistral_regex=True 跑新控制組;修正版沒有觀察到原警告。這兩個空 system 設定的延遲接近,不能據此宣稱 regex 修正提升或降低了摘要品質。
正常 stop,不代表記錄正確
抽看各設定的第一筆正式回覆,有幾個值得追蹤的細節:
Phi-4 Mini 原始設定那筆,把「週三前」寫成「週三」,期限語意改變。
Ministral 原生預設、空 system、空 system+regex 修正三個設定的那一筆,都省略了負責人「小林」。
Gemma E4B 那筆加入「本週」,原文沒有提供這個限定。
fm 那筆幾乎照抄原句;收到完整文字,不等於完成了摘要工作。
這是特定設定、特定輸出的觀察,不是錯誤率統計,也不是模型系列的品質結論。我沒有完成逐筆字數與語意評分,不能說另一個模型因此「比較準」。
真正做會議記錄,還得分別驗證 ASR、長逐字稿切分、owner/期限與原文引用。本篇沒有測這些,不能拿短摘要外推整場會議。
想自己量,可以先保留這些資料
1. 固定實際模型 repo/revision、量化版本與套件版本;模型先下載並載入。 2. 保存訊息、渲染提示、模板選項與輸入 token 數,不只保存使用者那一句。 3. 明訂計時起點,分開記冷啟、TTFT 與完整回覆;每組暖身一次再正式重複。 4. 保存完整輸出、finish reason、截斷與失敗,不拿正常停止當作答案正確。 5. 檢查任務真正重要的資訊:負責人、期限、前提與來源是否保留。
本次使用 MLX 0.32.4/mlx-lm 0.32.2
[Phi-4 Mini](https://huggingface.co/mlx-community/Phi-4-mini-instruct-4bit)
[Gemma 4 E2B](https://huggingface.co/mlx-community/gemma-4-e2b-it-4bit)
[Gemma 4 E4B](https://huggingface.co/mlx-community/gemma-4-e4b-it-4bit)
[Ministral 3 3B](https://huggingface.co/mlx-community/Ministral-3-3B-Instruct-2512-4bit)
這些是實測使用的社群量化版本,不是對原廠不同精度版本的評測。Apple system 權重的確切版本未知,不能拿記錄標籤當成 Apple revision。
這次還不能回答的事
單機、同一提示、每組五次,不能建立穩健能力榜或可靠 p95;沒有測長時間散熱、能耗、整機 CPU/RAM 或冷啟。MLX allocator peak 不等於 process RSS/整機記憶體,不能拿來跟 fm 比系統負擔。預先下載與 offline 旗標也不等於全機斷網驗證。
方法與原始紀錄仍保留;目前沒有公開下載網址,不假裝附件已經上線。實作可參考:
[MLX LM 官方文件](https://github.com/ml-explore/mlx-lm)
[Apple Foundation Models framework](https://developer.apple.com/documentation/foundationmodels)。
我的下一步不是再找一個排行榜冠軍,而是選一件真實工作,把延遲、證據與驗收一起量。