


上一篇,我用一句合成的會議描述,量文字模型多久回應。接著換成真實錄音,才發現更值得追問的瓶頸:不是模型怎麼寫摘要,而是前面的語音辨識,花的時間比錄音本身還長。
一份31分27秒的錄音,先前本機ASR跑了51分10秒。另一個獨立階段,Apple fm 對轉出的文字分四組產生摘要,約37.5秒。這兩個時間不能相加當作已量測的完整流程,但它們先提醒我:如果要減少這份工作的等待,應先查ASR,而不是先調摘要提示詞。
這篇想回答的問題很小:同一台M1 Air 16GB、同一個ASR模型、同一份錄音,調解碼搜尋、切片或有限並行,能不能真的縮短等待?變快時,有沒有悄悄少做事情?
錄音50分鐘,不代表處理一定50分鐘
RTF是處理時間除以音訊長度。先前那次用 whisper.cpp 搭配 Breeze-ASR-26 q4_0,1887.316秒錄音花了3070.342秒,RTF約1.627。這只是該設定、該次負載下的觀察,不是M1的硬體上限,也不是所有本機ASR的速度。
處理已錄好的檔案,與即時會議是兩件事。檔案已完整存在,可以排程、切片、批次處理;即時會議則至少要等聲音發生,還得看每段的持續吞吐量與延遲。
如果等會議結束才啟動這次離線轉寫,要再等的是完整的51分鐘,不是「51減31」的差值。我沒有測串流,也不能把離線RTF直接當成串流首字延遲。
先確認:是不是根本沒用GPU?
原執行紀錄顯示,Metal library與MTL backend已載入,也辨識出Apple M1;同時有CPU與BLAS後端。這排除了「完全沒載入GPU後端」的說法,卻沒有告訴我主要計算分到哪裡,更沒有GPU利用率證據。
所以,我不先認定它已用滿GPU,也不先認定多開兩份就能把GPU補滿。兩個程序共享同一顆晶片、記憶體與頻寬,可能縮短牆鐘時間,也可能只是增加載入、競爭與swap。
四組短片段實測:先固定規則再看數據
新的實驗固定在同一份錄音取開頭、中段、尾段,各90秒。四組都用同一個runtime、同一份權重與中文設定:
A,新基準:整段交給原生ASR;明確設定beam與best-of為5。
B,減少搜尋預算:整段處理,beam與best-of改為1。這是搜尋預算配置的比較,不宣稱只改一個因子。
C,序列切片:60秒一片、1秒重疊,一片接一片處理,解碼設定與A相同。
D,有限並行:與C相同的切片和設定,只把同時執行上限改為兩份。
短片段共兩輪反向測試(第一輪A→B→C→D,第二輪D→C→B→A),共24個case全部完成運算:
A(原生5/5):第一輪三段共265.723秒,第二輪277.838秒,平均271.781秒。程序合計取樣RSS峰值約1.75 GiB;2個case出現時間戳異常。
B(搜尋預算1/1):第一輪362.677秒,第二輪383.024秒,平均372.851秒,比基準A還要慢,且6個case都有時間戳越界。原以為降低搜尋會快,實測反而劣化。
C(序列切片):第一輪247.001秒,第二輪259.433秒,平均253.217秒,平均耗時比A少約6.8%,程序RSS約1.75 GiB。
D(切片+兩路並行):第一輪226.789秒,第二輪227.556秒,平均227.173秒,在短片段中耗時最短,平均比A少約16.4%。但代價是程序取樣RSS峰值翻倍到3.50 GiB,且6個case也全部出現片段時間戳異常。
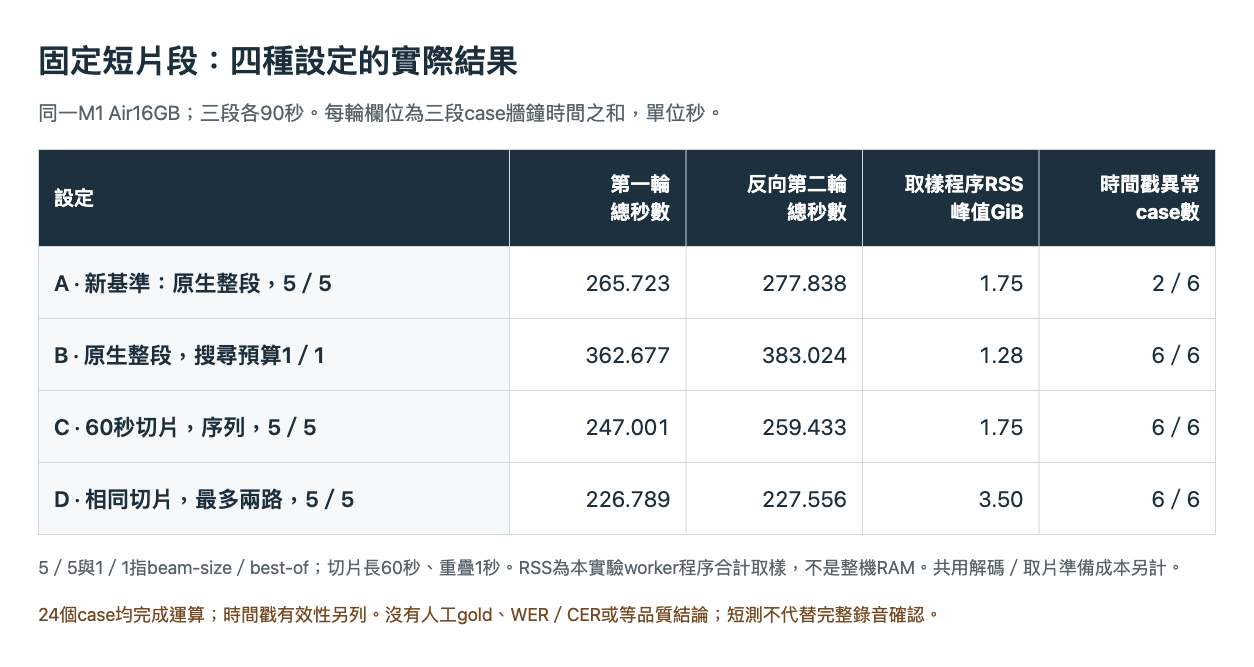
如果只看短片段的牆鐘秒數,很容易得出「D兩路並行勝出」的結論。但短片段的227秒不能直接乘以倍數當作完整錄音;真正的考驗在於完整錄音能否正常交付。
完整錄音確認:短測變快,完整交付卻失敗了
依事前凍結的規則,我把短片段中最快的D作為候選,回到完整的1887.36秒錄音上進行端到端確認。結果留下兩個重要的現實限制:
第一,完整的基準A跨越了系統休眠。
基準A跑出2801.469秒(RTF約1.484),看似比先前的51分鐘略短。但核對電源日誌發現,中途筆電合蓋休眠了數個小時。macOS的 time.monotonic() 依賴 mach_absolute_time(),系統休眠時時鐘會暫停計算。因此記錄到的2801秒只是「機器醒著的累計運算時間」,並不是使用者真實經歷的連續等待時間,不能當作乾淨受控的「之前」。
第二,完整D組的兩路並行在最後解析階段失敗。
完整D組共切為32片,32個 whisper-cli 程序全部以結束碼0退出。但嚴格檢查輸出時發現,第7片的JSON檔案在第1103個byte出現了無效UTF-8位元組(invalid continuation byte),導致32片只有31片能解析,整篇轉錄遺失了該片段。因為嚴格解析失敗,這場確認在紀錄中被判定為 compute_failed,沒有完成交付。
這正是只看短片段或只看程序結束碼會忽略的陷阱:程式結束碼0,不代表輸出合法;短片段跑得快,不代表切成幾十片後不會在邊界或編碼上翻車。
切片省時間,不能靠丟掉邊界
Whisper本來就有內部分窗。外部再切片,每片有啟動成本,重疊區算兩次,最後還要拼接。並行更不能只報最快worker的秒數,必須量全部結果完成的牆鐘時間。
時間軸尤其容易被漂亮數字掩蓋。基準A的完整輸出尾段超出音檔6.20秒;D組的片段也有3個片段越界,最長超出1.64秒。這些異常我都如實保留原值,沒有截成音檔長度來偽裝檢查過關。
在重疊處理上,本次實驗只有在相鄰切片的重疊秒數內出現完全相同的文字時,才標為重複片段;62個有效片段中有60個觸及重疊區,全部如實保留,未刪減任何可能重複講的內容。
我沒有人工逐字稿標準答案。因此,片段數、時間越界、空輸出、文字差異與記憶體只能作診斷,不能包裝成WER、CER或「品質完全不變」。兩份轉錄不同,不等於候選錯;基準也可能錯。
fm還能不能調快?
有值得研究的路徑,但它不是這次ASR對照的變因。
實際的 fm respond --help 有greedy、schema與串流開關,沒有公開temperature或最大輸出token旗標;Apple SDK的GenerationOptions才有這些控制。SDK也有prewarm與session快取相關能力,但提前載入是把工作前移,不是讓成本消失,串流也不保證縮短完整產物的時間。
先前37.5秒的摘要路徑已使用greedy與schema。即使把它減半,也只少約18.7秒,無法解決ASR數十分鐘的主要等待。對反覆短問答的日常助理,fm的首段延遲與session開銷則是另一個值得單獨量的問題。
這次留下的真實結論
這次測試沒有產出一個漂亮的「提升X倍」標題,反而揭露了工程上的真實代價:
不要盲目調小搜尋預算:B組把beam與best-of縮小到1,時間反而增加約37%,時間戳也全部越界。
切片與有限並行確實縮短了短片段運算:D組在90秒短片段上快了約16.4%,但記憶體翻倍至3.5 GiB。
短測變快,不等於系統可以穩定上線:完整D組32片全部以rc 0結束,卻因為單一切片輸出含有不合法UTF-8而無法整合成乾淨文件。如果在真實排程中沒有做結構與編碼驗收,直接餵給後續的LLM,整個pipeline就會無預警中斷。
筆電量測必須核對休眠事件:合蓋休眠會中斷真實牆鐘連續性,不嚴加審查就會把跨夜的無效數據寫進報告。
真正想做的日常助理,不是什麼都附和,也不是看到新想法就阻止。它應能接續既有工作、保存值得留的構想,並讓回答回到有日期與來源的紀錄。這次先處理其中一道基礎問題:資料進得來之後,多久能拿到可檢查的結果?
答案是:在16GB M1上,單靠切片與兩路並行,無法在缺乏強健容錯下安全交付完整音檔。下一步該改的不是提示詞,而是音訊切片管線的輸出編碼防禦與更穩健的本地ASR排程架構。